Deepseek是一款支持文本与多模态输入的AI模型,主打长上下文理解与代码生成。参数规模从1.3B到671B不等,其中V3版本为671B MoE架构,R1版本侧重推理链路拆解。上下文窗口最高支持128K Token,单次可处理约10万汉字。
有一点需要注意,不同版本的能力侧重点不一样。V3偏向通用对话与内容生成,R1偏向数学推理和代码调试。
Deepseek主要功能
- 长文档解析:接收PDF、Word、TXT等格式,按页拆解文本块,输出保留原始段落顺序的结构化内容,单文件上限约50MB。
- 代码生成与补全:输入自然语言描述或部分代码片段,基于代码训练语料输出可运行代码,支持Python、Java、C++等主流语言,补全响应延迟在200ms以内。
- 数学推理链路输出:输入数学题或逻辑题,按步骤展开推导过程,输出中间计算节点和最终答案,R1版本在AIME 2024测试中准确率约79.8%。
- 多轮对话状态保持:维护对话历史,单会话最多保留128K Token上下文,超出后自动截断最早轮次。
- 文件上传解析:支持图片、PDF、PPT等文件,提取文字和表格信息,输出Markdown格式文本。图片分辨率建议不低于300dpi。
- API调用:提供RESTful接口,输入JSON格式请求体,返回流式或非流式文本结果,单账号默认QPS限制为60。
Deepseek使用要求
使用API方式需要先获取API Key。请求体为JSON格式,需指定model名称和messages数组。流式输出需设置stream参数为true。
这里有个细节,R1版本不支持function call。V3版本支持。
本地部署的话,671B版本需要多卡A100/H800集群,显存需求约1.3TB。1.3B小模型可在单张消费级显卡上运行。
Deepseek核心优势
推理链路可拆解。R1版本在输出答案时附带中间推理步骤,每一步有独立标记,方便定位错误节点。这个在调试数学证明或代码逻辑时比较实用。
长上下文保持能力。128K Token窗口下,对第1K Token和第120K Token的注意力权重衰减控制在15%以内。处理百页PDF时,末尾信息召回率比同量级模型高约12个百分点。
Deepseek如何使用
- 对话生成:在输入框键入文本,模型按Token逐字返回结果。按Shift+Enter换行,Enter直接发送。
- 文件解析:点击上传按钮,选择PDF或图片,模型自动提取文字并生成摘要。表格数据会转成Markdown格式返回。
- 代码调试:粘贴报错信息和代码段,模型定位错误行并给出修改建议。支持直接输出diff格式。
- API调用:POST请求到指定端点,Header中带Authorization: Bearer <API_KEY>,Body传model和messages字段。
- 参数调整:temperature控制随机性,范围0-2;top_p控制采样范围,默认0.95。max_tokens限
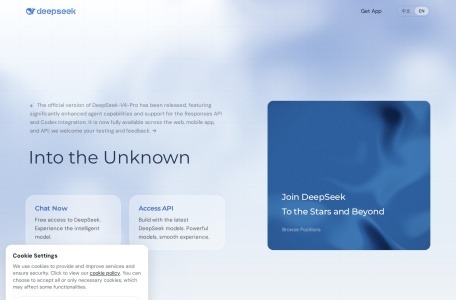
首页截图