CodeBuddy 是一套面向中文开发场景的 AI 编程助手,主打代码生成与项目级理解。底层接入多款大语言模型,能处理自然语言到代码的双向转换。
和常见补全插件不同,它把整个工程目录当作上下文来读。输入一段需求描述,输出可运行的函数或模块。支持的语言以主流后端和前端为主。
有一点需要注意,上下文窗口有大小限制,超大仓库需要分批索引。
CodeBuddy主要功能
- 代码补全:根据当前光标位置和已打开文件内容,实时生成后续代码片段。机制是本地缓存 + 云端推理,单次响应一般控制在几百毫秒内,输出为可直接插入的代码块。
- 整文件生成:输入功能描述,比如“写一个带分页的查询接口”,输出完整文件。走的是模板 + 模型混合路径,生成结果保留缩进和注释,支持导出为 .py、.js、.java 等格式。
- 代码解释:选中一段代码,返回逐行说明。输入支持单文件或选中片段,输出为 Markdown 文本,单次处理上限约 8000 Token。
- 单元测试生成:读取函数签名和内部逻辑,输出对应测试用例。能识别 pytest、JUnit 等框架,生成的用例默认带断言和边界值。
- 错误诊断:粘贴报错堆栈,定位到具体行并给出修改建议。输入是文本形式的日志,输出为修改前后的 diff 对比。
- 多轮对话改写:在对话里追加需求,比如“改成异步的”,模型基于上一轮结果继续改。保留历史上下文,轮次上限 20 轮左右。
CodeBuddy使用要求
- 需要联网。本地推理版本暂未开放。
- 浏览器建议 Chrome 90+ 或 Edge 90+。IDE 插件版支持 VS Code 1.70 以上。
- 单文件处理上限约 1MB。超出后需要手动拆分。
- 免费额度按天计算,具体数值以账户页显示为准。这里有个细节,额度消耗和文件大小挂钩,大文件会扣得更多。
CodeBuddy核心优势
工程级上下文读取。不只看当前文件,会顺着 import 关系往上找依赖。生成结果更贴合项目已有风格。
中文需求直译。用中文描述业务逻辑,输出的变量名和注释默认也是中文。省去二次翻译。
实际使用时会有差异,模型对中文长句的拆解偶尔会偏。
CodeBuddy如何使用
- 在编辑器里选中代码,右键调出菜单,点“解释这段”。
- 新建文件,用注释写需求,触发补全。
- 打开侧边栏对话框,输入报错信息,等诊断结果。
- 生成测试用例后,手动跑一遍再决定是否保留。
- 改写功能:在对话里追加指令,不要重新开窗口。
CodeBuddy同类竞品对比
| 对比维度 |
CodeBuddy |
GitHub Copilot |
通义灵码 |
| 功能范围 |
补全、整文件生成、解释、测试生成、错误诊断 |
以补全和对话为主,测试生成较弱 |
补全、解释、单元测试,缺少整文件生成 |
| 数据处理 |
单文件上限 1MB,上下文约 8000 Token |
上下文较大,但中文注释处理一般 |
中文友好,工程级依赖读取偏弱 |
| 中文支持 |
中文需求直出中文代码和注释 |
中文描述常输出英文命名 |
中文支持好,但变量名有时不统一 |
| 定价 |
有免费日额度,超出按量 |
订阅制,无免费日额度 |
免费额度较宽,但高级模型需付费 |
| IDE 集成 |
VS Code 插件 + 网页版 |
多 IDE 官方插件 |
VS Code 和 JetBrains 插件 |
CodeBuddy应用场景
- 老项目加新接口。读一遍现有 Controller 写法,生成风格一致的代码。
- 接手陌生模块。选中整段逻辑,输出逐行解释。
- 补测试。对没写用例的工具类,批量生成 pytest 文件。
- 修报错。把堆栈贴进对话框,拿到定位和改法。
CodeBuddy适用人群
- 后端开发。日常写 CRUD 和接口,需要快速出模板代码。
- 前端开发。组件逻辑重复度高,靠补全省打字。
- 测试人员。给已有函数补用例,减少手写断言。
- 转语言的人。不熟新语法时,靠解释功能过渡。
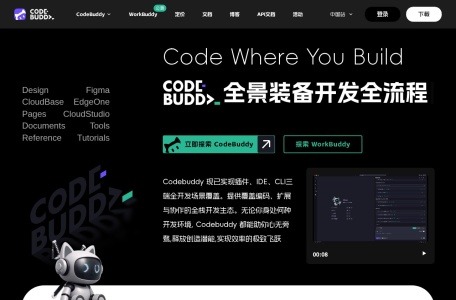
首页截图